记拾光集站点的优化过程
记拾光集站点的优化过程
站点跑在阿里云一台机器上,Spring Boot 加 Vue 3,一个人维护。麻雀虽小,五脏俱全:前后端分离、HTTPS、预渲染、SEO、CDN,还挂着一个自带知识库的 AI 分身。
前几天抽出空,从里到外顺了一遍,顺序是这样:
- 把前端从 Spring 里拆出来,nginx 发静态文件,接口按 /api 反代回去;
- 给域名装上证书,整站走 HTTPS;
- 做预渲染,让爬虫抓到的 HTML 里带真内容;
- 补 title、description、sitemap 这些 SEO 骨架;
- 静态资源接上 CDN。
前 4 步都顺,第 5 步卡住了,站点直接打不开。问题出在 CDN 一个没开的开关上,放在末尾说。
前后端拆开,nginx 只发静态文件
原来前端打包出来的东西和 Spring 跑在一起,JS 和图片都得先过一遍 Java。改成 nginx 直接返回构建产物,接口按 /api 反代给 Spring。两边都轻了。
前端路由用 History 模式,这里有个必配项:nginx 要把找不到的路径兜回 index.html。少这一行,首页能开,刷新子路由直接 404。
location / {
    try_files $uri $uri/ /index.html;
}
反代那边只有 3 行,把 /api 前缀整个交给 Spring:
location /api/ {
    proxy_pass http://127.0.0.1:8080/;
}
附带好处是发布解耦了:改一次样式只要重传 dist 目录,不用重启 Java 进程。
整条链路长这样:
证书:DV 单域名,记好到期日
个人站用 DV 证书就够,签得快,不用提交营业执照。签完把证书文件装到 nginx 上,站点就走 HTTPS。
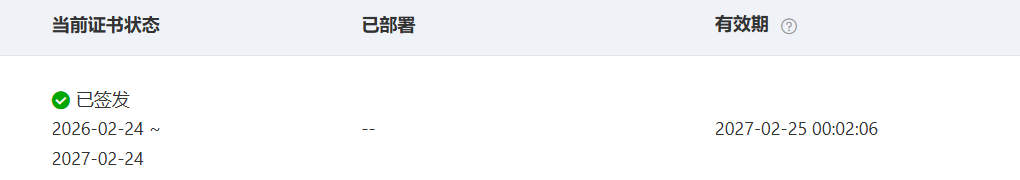
证书有期限。我这张是 2026-02-24 到 2027-02-24,一年一续。
| 项 | 值 |
|---|---|
| 品牌 / 算法 | DigiCert · RSA_2048 |
| 类型 | DV 单域名 |
| 有效期 | 2026-02-24 到 2027-02-24 |
源站装上证书之后,CDN 那边也得能提供 HTTPS。域名列表里那列 HTTPS 就管这个,不开的话读者到节点这段还是明文。
到期日我在日历里加了提醒。过期那一秒浏览器会把站点拦成红色警告页,比样式错乱难看多了。
预渲染:让爬虫拿到真内容
Vue 是单页应用,返回的 HTML 里只有一个空 div,正文全靠 JS 填。浏览器会执行 JS,人看着正常;爬虫多半不执行,或执行不完整,抓到的就是一张空页。
站点在百度那边一直没内容,根子在这里。
做法是打包完之后用无头浏览器把每个路由跑一遍,等渲染完把当时的 DOM 存成静态 HTML。nginx 优先返回这些静态文件,没有对应文件的再走兜底。
哪些路由进快照要先划界限。首页、列表页、文章详情页一个都不能少;带登录态的后台页不该进,存进去就是个没登录的壳子,容易出事。
路径是动态的,详情页那种带 id 的,跑快照前得先从接口把 id 列表拉出来挨个生成。只跑固定路由,详情页等于没做。
这里踩过一个坑:预渲染必须放在前端 build 之后、镜像打包之前。我有一次顺序放错,快照里引用的还是上一版构建的资源哈希,页面能打开但样式全丢,两边不是同一代产物。
SEO:骨架补齐,剩下交给时间
预渲染让 HTML 里有了真内容,接下来才是 SEO 的活。
每个页面要有独立的 title 和 description,得在渲染时写进去,否则所有路由共用一个标题。再补上 sitemap.xml 和 robots.txt,去搜索引擎的资源平台提交掉。
description 不堆关键词,写一句人能读的话就行。分享出去的卡片用的就是它,硬塞关键词只会让卡片变难看。
提交完就等,收录是慢活。
Google 那边先有反应。搜自己的名字,第一条就是站点首页,标题和描述都是预渲染时写进去的那两句。
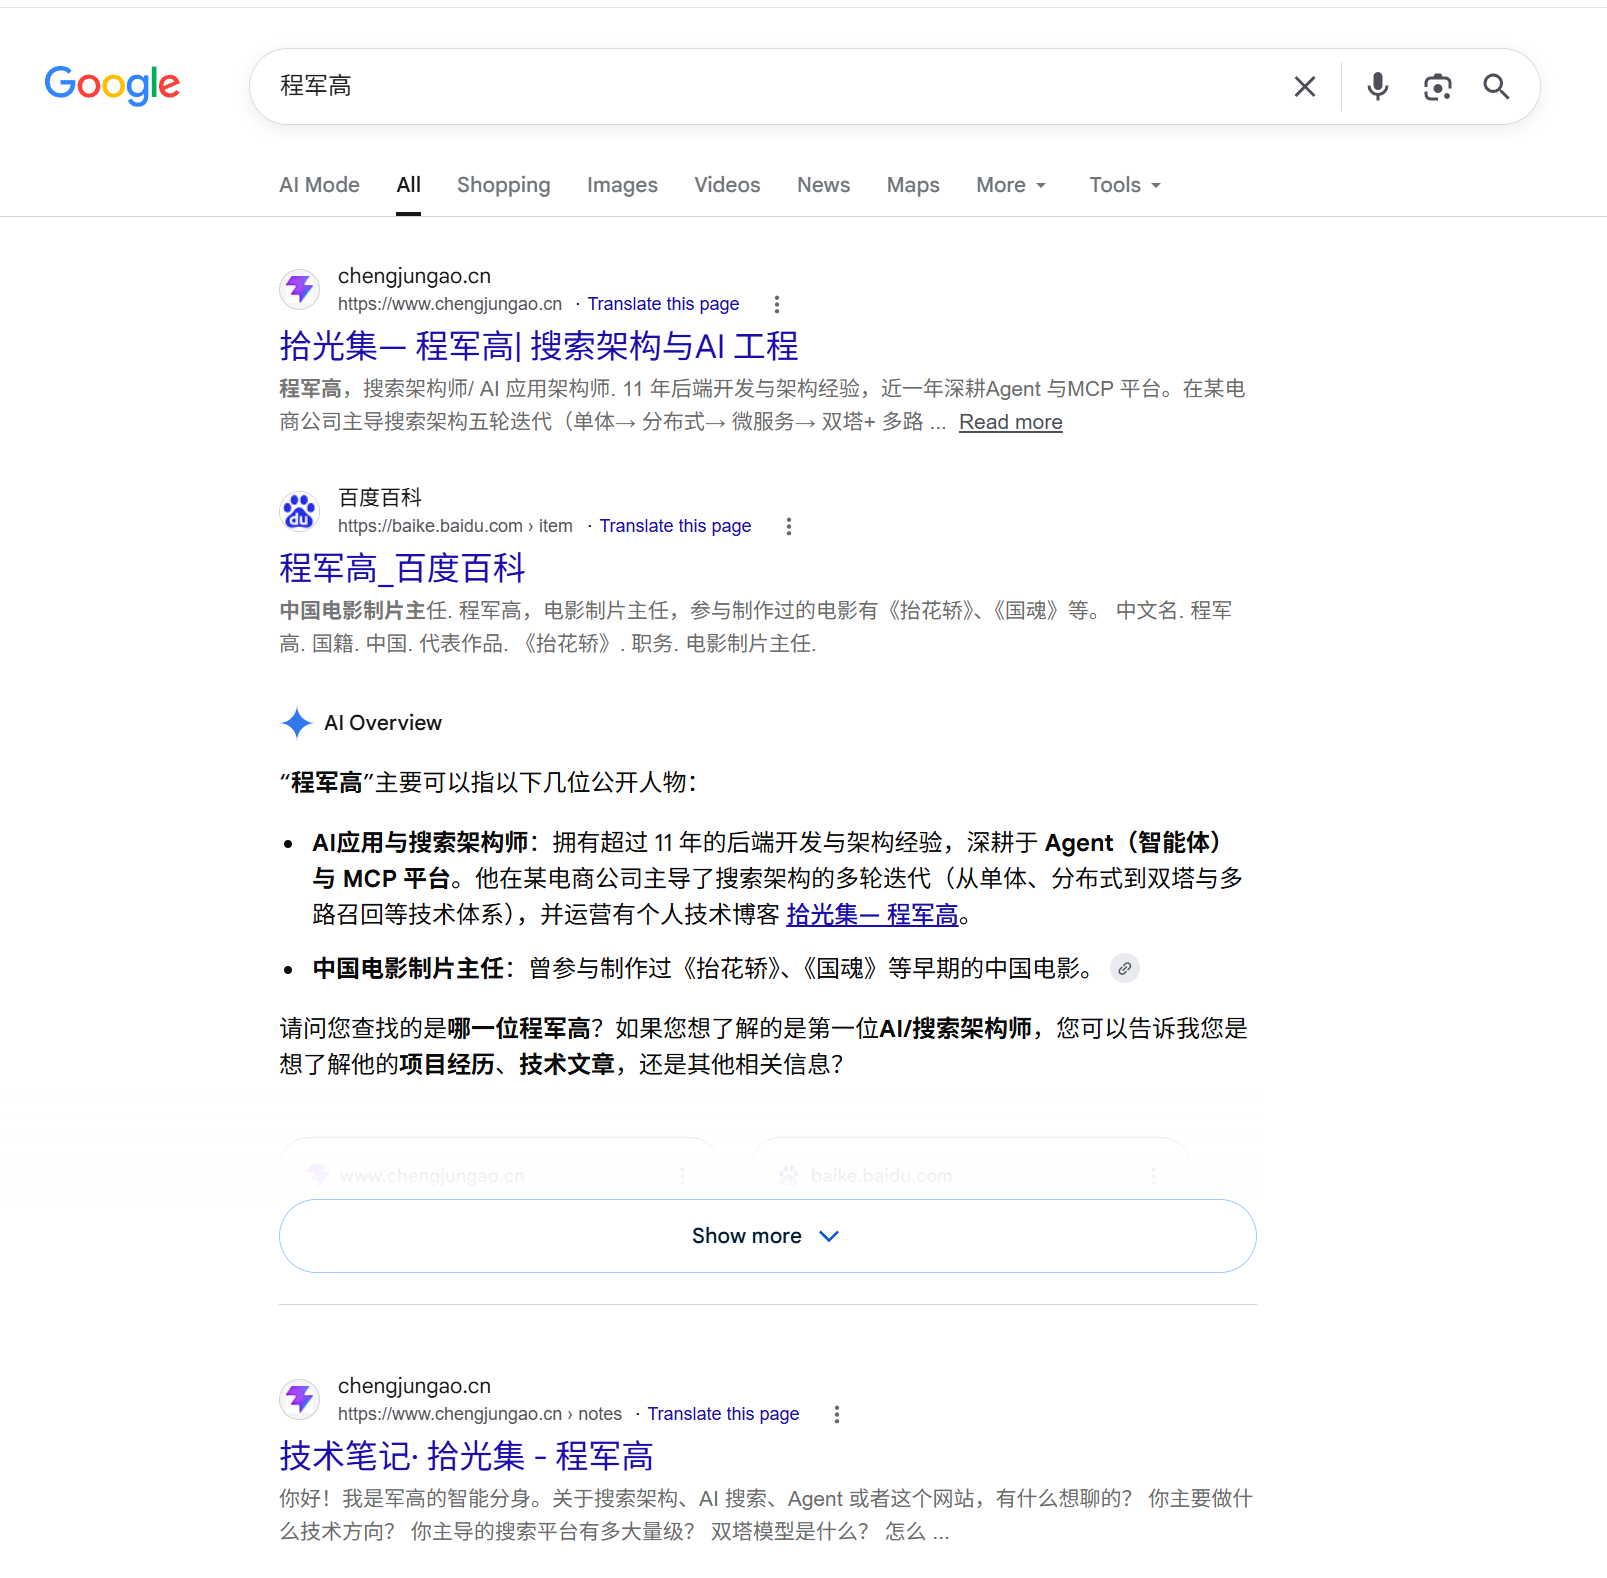
同一页上那块 AI 概览,把我概括成「AI 应用与搜索架构师」「深耕 Agent 与 MCP 平台」,跟描述里的说法基本一致。那页里还挂着一位同名电影人的词条。
不过 SEO 那些活都是给搜索引擎排名做的。大模型也来抓网页,却没人给它准备一份能直接读懂的文件,拿到的是 HTML,正文埋在导航和样式中间。
我补了一份 llms.txt,放在站点根目录(www.chengjungao.cn/llms.txt)。第一行站点名,紧跟一句自我介绍,下面按栏目分组列链接和说明。截一段出来,域名省了:
# 程军高的技术博客

> 搜索、AI、架构、工程实践

## 主要栏目

- [技术笔记](/notes) - 技术文章和教程
- [生活杂记](/life) - 读书做菜笔记

## 最新文章

- [某篇文章](/langchain-11)
  - 分类: Agent
跟 sitemap 的区别在描述。sitemap 只给 URL,模型得抓一遍页面才知道每篇写什么;这份文件把栏目、文章、分类一次带全,还各配一句话。文件用脚本生成。
现在还没有哪家平台承诺一定读它。但把站点结构主动交出去,总比等模型自己摸索强。
AI 分身:站里也放了一个
右下角挂了个聊天入口,点开就能问。它管自己叫智能分身,开场白是「关于搜索架构、AI 搜索、Agent 或者这个网站,有什么想聊的」。
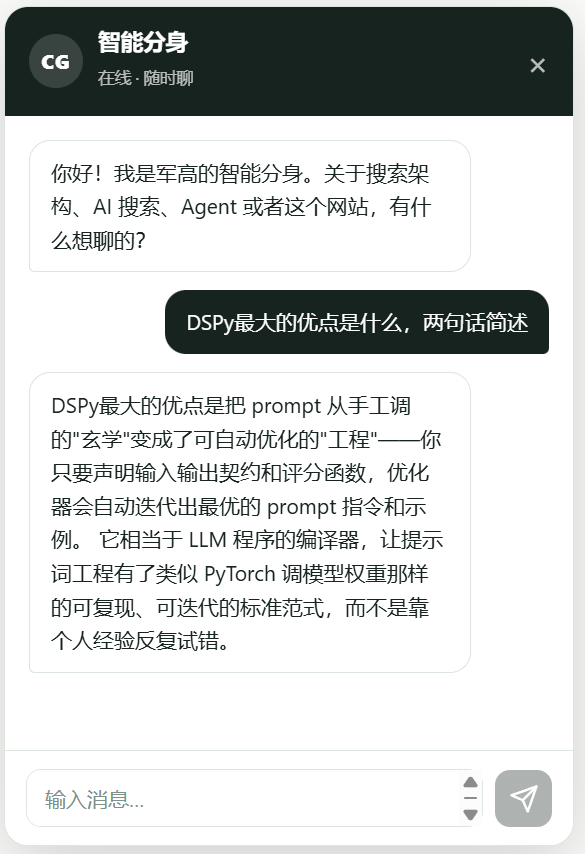
它答得靠谱,靠的不是把整站文章塞进上下文,那早就超了。后台挂着一个简易知识库,文章先切块存好,提问时先捞出相关的几段,再交给模型组织成回答。图上问的是 DSPy 的优点,回答基本就是站上那篇 DSPy 文章的浓缩。
这块跟 SEO 那节方向不同:llms.txt 是把站交给外面的模型,AI 分身是让读者在站里直接问。
CDN 接上之后,站点打不开了
源站只有一台机器,离得远的读者取图要绕远路。CDN 把静态资源缓存在离读者近的节点上,这一步冲着图片慢去。
配置流程没什么特别:新增域名,业务类型选图片小文件;拿到 CNAME 去 DNS 加解析记录;再做 TXT 记录给证书验证。等提示出「域名的 DNS 信息配置正确」,这步就过了。
DNS 记录改完不是立刻生效。TTL 我设成 10 分钟,等了一会儿才看到解析指过去。
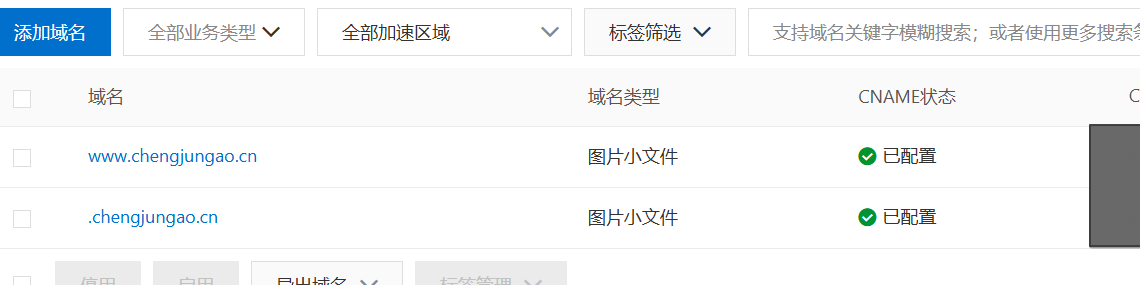
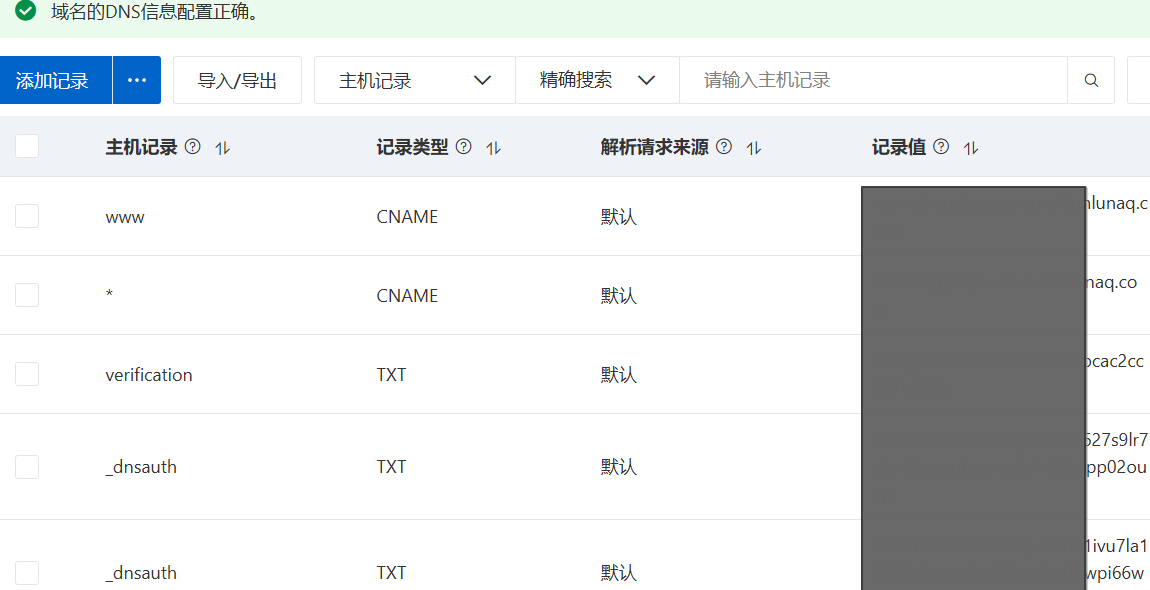
然后就打不开了。
翻刚动过的地方。DNS 逐条对了一遍,CNAME 指的方向没错,也没有冲突记录;绕开 CDN 直接打源站是好的。问题就落在 CDN 到源站这一段。
回到 CDN 的域名配置里一项项翻,翻到「回源协议」,这一项是关着的。CDN 默认按 HTTP、80 端口回源,源站走的是 HTTPS,两边对不上,请求卡在中间回不来。
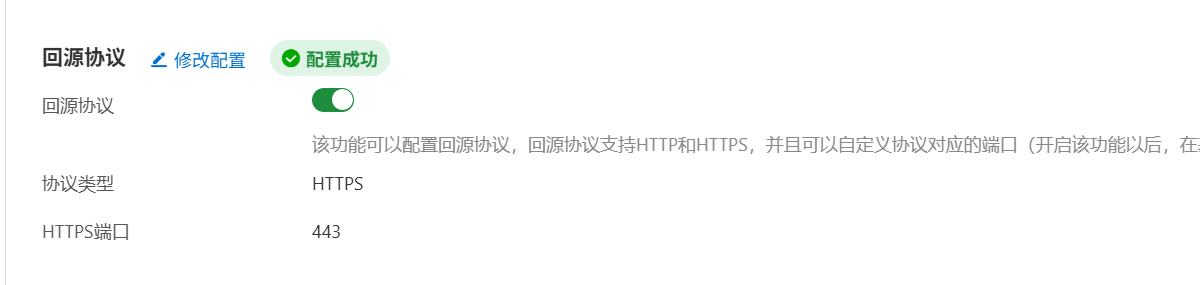
把回源协议打开,协议类型选 HTTPS,端口 443,保存。刷新,站点回来了。
| 配置项 | 值 |
|---|---|
| 回源协议 | 开启 |
| 协议类型 | HTTPS |
| HTTPS 端口 | 443 |
CDN 的默认值照着「源站跑 HTTP」设。源站换成 HTTPS 后,这个开关得自己记得打开,它藏在一个折叠的配置项里。
后面
装证书、写 sitemap 都是照文档走的活,真正卡住我的是 CDN 那个默认值。
后面打算加个到期监控,域名和证书提前一周提醒我。
你给自己的站点做过哪一步优化,或者也踩过哪个「默认值」的坑,留言区聊聊。