LangChain系列之一个完整 Agent 实战:3 条支线、3 层记忆、3 道护栏
一个完整 Agent 实战:3 条支线、3 层记忆、3 道护栏
这套零件我拆了 10 篇。上下文、记忆、工具、评测、护栏,每一件单独拿出来都能讲清楚。
可前阵子我想把产线里那个搜索 Agent 的骨架抽出来,做成一个别人下载下来就能跑的东西时,还是在同一个地方卡了很久。
卡住我的不是零件,是接缝。
记忆该在哪一轮召回、路由按什么切才不打架、checkpoint 该存在哪一层、评测集怎么覆盖多 Agent 场景,这四个问题前面没有一篇讲得到,因为每一篇都在讲一件零件。
装配本身是一件独立的手艺。
所以这一篇不教新东西。我只做一件事:把这些零件装成一个能跑、能验、能改的完整项目,然后把装配过程中塌过的三个地方指给你看。
一、把零件装成一条线
1.1 零件都在,缺的是焊点
先把家底盘一遍。前面那些文章给过你这些东西:
这张图里每一格你都见过。真正的问题是中间那条线:这 13 个零件装进一个工程,每个落在哪一层、由谁调用、出错了谁兜。
我把这件事做成一张映射表。这张表是整篇文章的骨架。
| 零件 | 来自 | 在购物助手里的落点 |
|---|---|---|
| 模型装配与工厂 | 《LangChain 1.0 之后》 | make_brain() 双后端:规则实现 / 真实端点 |
| 结构化输出 | 《模型 I/O 与结构化输出》 | 意图识别节点,Pydantic 定义 Route |
| 检索增强 | 《RAG 实战》 | 商品检索 + 政策检索,纯 Python BM25 |
| StateGraph 主图 | 《LangGraph 实战》 | 一张主图承载全链路 |
| checkpointer | 《LangGraph 进阶》 | SQLite 落盘,会话可续 |
| interrupt 中断 | 《LangGraph 进阶》 | 下单前的金额确认 |
| 上下文治理 | 《Agent 的记忆(上)》 | 长会话裁剪 + 早期摘要 |
| 长期记忆 | 《Agent 的记忆(下)》 | 用户画像与事件记忆,跨会话召回 |
| 工具分层 | 《MCP 与 Skills 接入》 | 货架与清单分离,按支线发工具 |
| Skill 承载流程 | 《MCP 与 Skills 接入》 | 退换货判定写成 markdown |
| 多 Agent 路由 | 《多 Agent:拆之前,先回答这 3 个问题》 | 导购 / 订单 / 客服三条支线 |
| 评测集与轨迹 | 《评测与监控》 | 20 条用例 + 每轮轨迹落盘 |
| 上线护栏 | 《Agent 上线实战》 | 幂等键、轮数上限、金额阈值 |
装完这一遍我才发现,映射表里最容易被低估的是最后两行。评测和护栏在前面的文章里都是独立话题,装进来之后它们不是两个模块,是两层网:轨迹每轮都写,护栏在每一步都站着。
1.2 这个工程长什么样
它是一套浏览器应用,不是一个脚本集合。
pip install -r requirements.txt
python run.py
跑完这两行,浏览器会打开 http://127.0.0.1:8765,不配模型也能用。界面左边是对话,可以选 5 个不同的用户身份,方便你看同一句话对不同人的反应。
右侧是过程面板,路由到了哪条线、调了什么工具、召回了哪几条记忆、上下文裁掉了几条,都在上面。右上角是模型设置,填地址和密钥就换成真模型。
五条硬标准,是我做这个工程时给自己定的:
| 标准 | 具体到什么程度 |
|---|---|
| 零配置可跑 | 不联网、不要密钥,python run.py 起服务就能对话。没配模型时走内置规则实现,链路完整,只是回答死板 |
| 可切真模型 | 界面上填地址与密钥即可。本地服务与云端都在预设里,配好点一下「测试连接」 |
| 过程可见 | 每轮的路由依据、工具调用、记忆召回、上下文治理、真实 token 用量,界面上都能看见 |
| 可改 | 数据是 JSONL,工具与提示词分层。换成自己的数据不用动主图 |
| 能上生产 | 九处外部依赖各自收在一个文件或一个函数里,逐个换掉就行,主图一行都不用动 |
最后一条是这一篇真正想给你的东西。这五条合起来,给出的是一副能换零件的骨架。模型、数据、检索、记忆、存储、工具、业务口径、界面,每一处都是一个单独的接口。
第十一章会把九处接口逐个列出来,写明每一处改哪个文件、换成什么。
第三条我要多说一句。一个看不见内部过程的 Agent,你没法调试它。
这个工程里第九章要讲的三处塌陷,全部是靠过程面板抓出来的。光看对话,你完全看不出来。
1.3 先说清楚它不做什么
做这种项目最怕贪心。我砍掉的东西比留下的多:
- 不做真实支付。 下单落一条记录进本地文件,没有支付网关,没有回调。
- 不接向量库。 检索是纯 Python 的 BM25,为了让人解压就能跑,不为了效果。
- 不做多进程。 单进程跑。真要多副本部署,幂等和记忆的那两个 SQLite 得换成服务端存储。
- 不追求回答质量。 它的价值在链路完整,不在答得多聪明。换个 9B 模型,你马上能感觉到它的天花板。
这四条边界我会在结尾再提一次。能说清自己做不到什么,是一个工程可用的前提。
二、先造一份数据
2.1 为什么先做数据
写 Agent 工程有个顺序问题:先写代码还是先造数据。
我的经验是先造数据。因为数据会反过来决定代码的形状。
你手上只有「商品」和「价格」两张表,检索永远写不出「差评集中点」这种查询。你手上没有促销规则里那个 stackable 字段,算价就永远不会遇到叠加的坑。
这个工程的数据是 7 个 JSONL,全部构造,商品与品牌均为虚构:
| 文件 | 条数 | 说明 |
|---|---|---|
products.jsonl |
40 | 商品,耳机 20 / 键盘 12 / 显示器 8。specs 是异构字典 |
users.jsonl |
5 | 用户档案:偏好、回避、身体条件、常去场景 |
orders.jsonl |
12 | 历史订单 |
logistics.jsonl |
12 | 物流轨迹 |
policies.jsonl |
27 | 平台规则,带 scope 支持先过滤再排序 |
reviews.jsonl |
60 | 评价,带标签,支持按标签聚合 |
promotions.jsonl |
10 | 促销规则,带 stackable 与生效时间 |
2.2 三个设计决定
第一,specs 用异构字典,不用固定列。 耳机的参数是降噪深度和续航,键盘的参数是轴体和配列,显示器的参数是分辨率和刷新率。把它们硬塞进一张宽表,80% 的格子是空的。
异构字典的代价是「参数对比」这个工具必须写得通用。这恰恰是好事:真实商品数据就长这样,你早晚要写通用版本。
第二,订单直接引用业务化编码。 我第一版让订单里的商品用「第几个商品」的位置索引。结果增删一个商品,所有订单集体错位。改成 SKU-E1001 这种带类目前缀的编码之后,这个问题再没出现过。
第三,评价按类目分开生成。 混用一个评价池会造出「耳机评价里说屏幕有坏点」这种东西。分开之后还要注意一点:差评不是低分商品的专利。 销量大的商品评价多,必然混着几条差评。我按「低分商品 + 每隔几个」两条规则铺,最后 13 个商品带差评。
2.3 校验器比人眼可靠
写了一个 31 项的校验脚本,跑起来一句话:
python eval/validate_data.py
它抓出来的问题,一个都不是我肉眼发现的:
| 问题 | 现场 | 根因 |
|---|---|---|
| 订单引用的商品全部错位 | 12 笔订单里的 SKU 全对不上 | 用位置索引当外键,增删商品就集体偏移 |
| 成交价与单价 × 数量不自洽 | 手写的成交价对不上乘法结果 | 常量手写,没跟着单价改 |
| 评价与类目串味 | 耳机评价里出现屏幕坏点 | 各类目共用一个评价池 |
| 差评覆盖不足 | 只有 9 个商品带差评 | 只按评分挑,漏了「销量大必然有差评」这条规律 |
这 4 项全部由校验器抓出。数据层的错误,后果是后面所有环节一起错,而且错得很像对的。 值得为它写一个专门的脚本。
三、一张图承载整条链路
3.1 主图只有 4 个环节
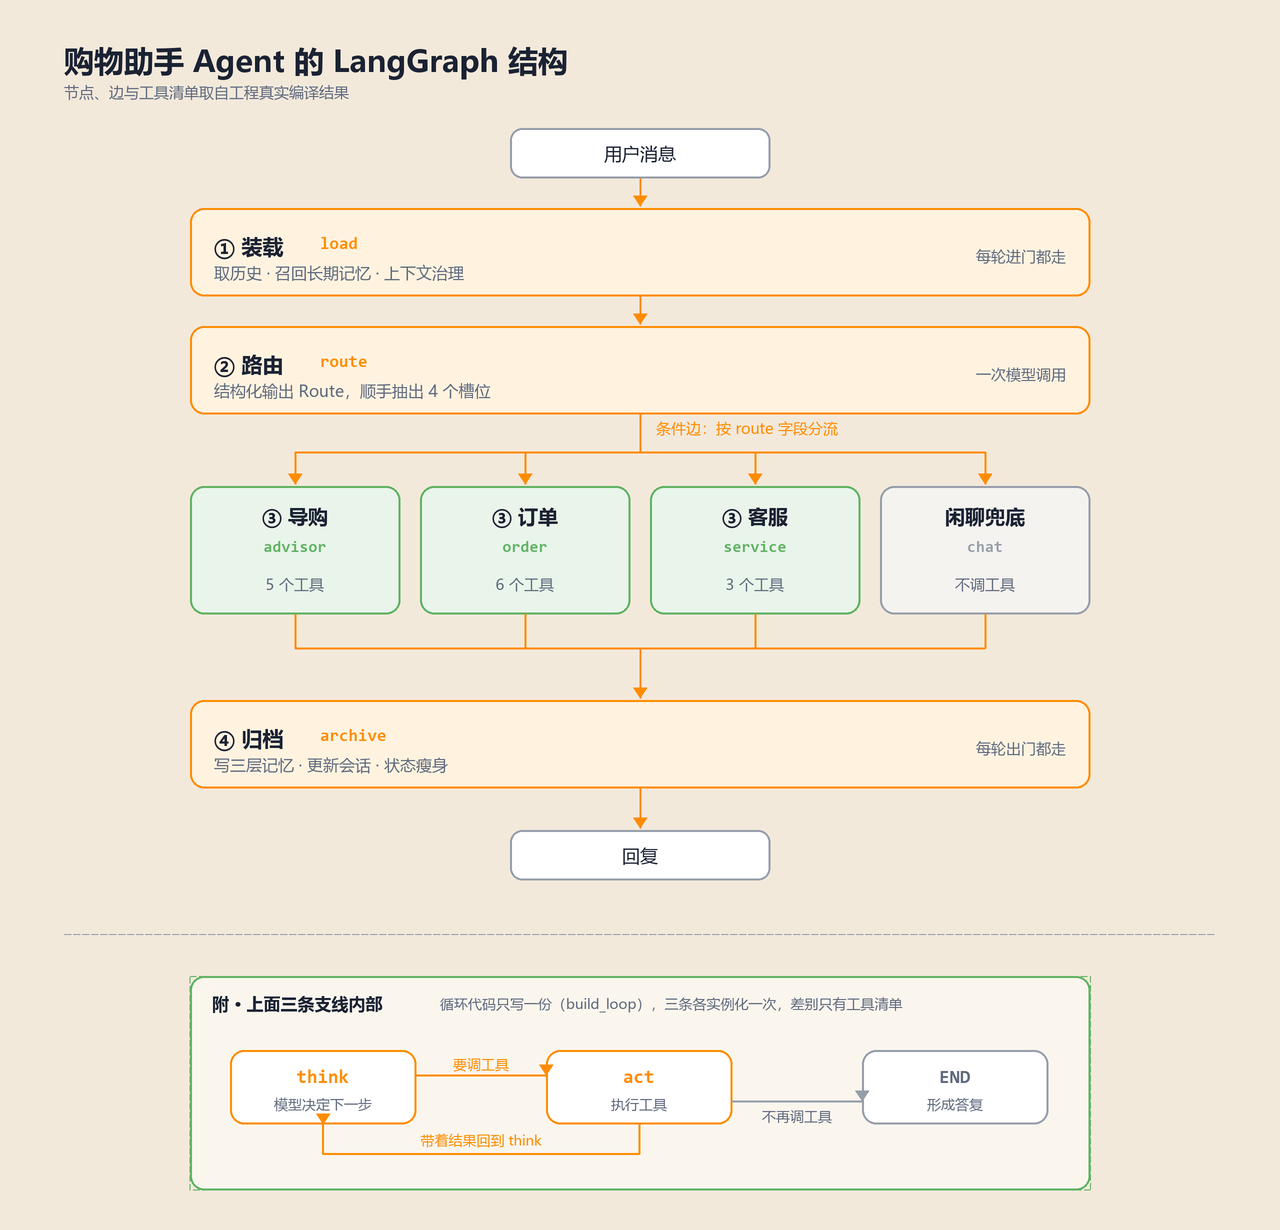
上面这张图不是画出来的示意图。每一个节点名、每一条边、每一组工具数量,都是从工程的编译结果里打出来的:
app = build_graph(sess)
print(app.get_graph(xray=1).draw_mermaid())
图的最下方那块是附注,讲三条支线内部长什么样。把那一层摘掉,整条链路只剩下四个环节:
四个环节。这张骨架和大多数人的第一直觉不一样:三条支线是并列的子图,不是一个循环里的三个分支。 每条支线有自己的循环、自己的工具清单、自己的轮数预算。
主图只干两件所有支线都要干的事,进门治理上下文,出门写记忆。
3.2 为什么这两件事必须放主图
这是个很容易做错的决定。直觉上「谁用到谁处理」:导购线自己裁上下文,客服线自己写记忆。
我第一版就是这么写的,然后踩了两个坑:
| 放哪 | 后果 |
|---|---|
| 治理放在各支线 | 三条线拿到的历史不一致。改一处裁剪策略要改三处,很容易改漏一处,同一句话在不同支线里行为不一样 |
| 归档放在各支线 | 只在导购线归档时,用户在客服线说过的偏好在导购线就不存在了。这是很常见的漏 |
所以现在的做法是:治理放在进门前,归档放在出门后,支线只管自己那件事。
状态里有两条线要分清:messages 保留全量,送给模型的却是裁剪过的。保留全量是为了可追溯,裁剪是为了省钱和让模型看得清。 这两件事混在一起,你会在这两个目标之间反复摇摆。
3.3 路由为什么放在第二层
路由放在「装载之后、支线之前」,是因为它需要两样东西都到位:裁剪好的历史(判断上下文),召回好的记忆(判断这个人是谁)。
路由本身是一次结构化输出,输出一个 Pydantic 模型:
class Route(BaseModel):
    route: Literal["advisor", "order", "service", "chat"]
    reason: str
    category: str = ""
    budget_max: float | None = None
    sku_id: str = ""
    order_id: str = ""
注意后 4 个字段。它们是路由这一步顺手抽出来的槽位,会存进会话状态,交给支线用。
这一步是小投入大回报。不留这些槽位,支线就不知道用户刚说过「预算一千以内」,于是把这句话再问一遍。
而这次抽取的钱已经花过了,信息丢掉等于白花。
路由的判据只有一条,我在提示词里写得很重:
分界只看一件事:这句话要的是「了解」还是「办掉」。
「这款耳机怎么样」是要了解,走导购。「就这个,买了」是要办掉,走订单,哪怕句子里带着商品名和规格。这条线在第九章还会回来,因为模型在这里翻过车。
四、该动几个 Agent
4.1 三条支线不是三个 Agent
前面有篇文章算过一笔账,动一个专家省一半,动三个贵一半。那笔账在这里要重新算一遍,因为这个工程的切法和那篇不一样。
| 切法 | 怎么切 | 成本 |
|---|---|---|
| 1 个大 Agent | 所有工具都给它,一个循环跑到底 | 提示词最长,工具定义最多,每次判断都要看全部 |
| 3 个平级 Agent | 三条线各一个完整 Agent,互相转交 | 转交要额外一轮模型调用,且容易来回推诿 |
| 3 条支线共用一个循环 | 同一个循环实现,只换工具清单与提示词 | 只在路由上多花一次调用 |
这个工程用的是第三种。它的关键在「共用」两个字:循环的代码只写了一份(build_loop),三条支线各自实例化一次,差别只有三个参数:
tools = shelf.for_role(role)
budget = max_rounds or sess.cfg.max_rounds
system = build_system(role, sess, ...)
共用一个循环,省下的是三份重复的代码;换掉工具清单,得到的是三份不同的权限。
4.2 工具按支线发,不按需要发
工具清单长这样:
TOOL_GROUPS = {
    "advisor": ("search_products", "get_product", "compare_products",
                "get_reviews", "recall_preferences"),
    "order": ("search_products", "list_my_orders", "get_order",
              "get_logistics", "quote_price", "place_order"),
    "service": ("search_policies", "check_return", "create_ticket"),
}
导购线拿不到 place_order。这个决定救过一次:用户问「这款怎么样」,导购线即使动了手,也没有下单这个工具可用。
工具越多,误选概率越高,而且每个工具的定义都要占提示词的 token。发它用得上的那几个,是同时省成本和降风险。
这里有个细节值得单说。订单线里我塞了一个只读的 search_products:
| 支线 | 加了什么 | 为什么 |
|---|---|---|
| 订单线 | search_products |
用户说的是商品名,而 place_order 要的是商品编码 |
不加这个工具的时候,用户说「帮我下单明砚那款带鱼屏」,订单线会回头反问「请问 SKU 是多少」。这一轮对话在真实场景里非常扫兴。它是只读工具,放进订单线不增加写风险。
4.3 什么时候该多切一个
分不分线,我按这三条判断:
| 判据 | 说明 |
|---|---|
| 工具集能不能分开 | 几条线要用的工具高度重叠,切了等于没切,反而多一次路由花销 |
| 权限要不要隔开 | 有一条线有写操作、另一条完全没有,这个隔离本身就有价值 |
| 提示词会不会打架 | 导购要热情推荐,客服要谨慎不下结论。这两套语气硬塞进一个提示词,模型会精神分裂 |
第三条最容易被忽略,也最直接影响体验。语气冲突是分线的一个硬理由,跟成本无关。
五、导购线:检索、比价与「记得你」
5.1 检索用 BM25,不引向量库
这个决定在开篇讲过:为了让工程解压就能跑。这里说代价。
BM25 是字面匹配。中文没有空格,我用二元切分代替词典分词,「主动降噪耳机」切成 主动 / 动降 / 降噪 / 噪耳 / 耳机。它不需要维护词典,对短语匹配反而更稳。
政策库有个额外设计:每份文档带一个 scope 字段(退换货 / 运费 / 发票 / 保修 / 价保 / 促销)。检索时先按业务域过滤,再在文本上排序。
index.search(query, top_k=5, where=lambda doc_id: docs[doc_id].scope == "退换货")
这一步很有用。「七天无理由退货,运费谁出」这个问题,不过滤的时候会被「发票怎么开」这类文档挤掉名次;过滤之后,正确的两份文档排在第一第二,分数 17.46 和 15.26。这是真实检索系统里的 field filter,它和排序是两件事。
5.2 四类边界,我一条都没藏
检索跑了 4 类典型查询,结果都留着,包括难看的:
| 查询 | 结果 | 性质 |
|---|---|---|
| 通勤 降噪 耳机 | 聆风 A1 排第一,6.28 分 | 正常命中 |
| 三百以内 新手 | 零命中 | 价格是结构化条件,不是文本。「三百以内」这四个字在任何商品标题里都不出现 |
| 发票要多久 | 「发票内容可以修改吗」排第一 | 词汇鸿沟。用户说「多久」,文档写「时间」,字面对不上 |
| 满减和优惠券能一起用吗 | 补了文档后 13.40 分排第一 | 原本没有正确答案,这是语料缺口,不是检索错 |
| 显示器有坏点能不能换 | 排序不稳 | 短查询里的实词被「显示」「大件」这类泛词稀释 |
第三行那个是设计问题而不是技术问题。检索返回了不对的文档,但真相是语料里根本没有这份规则。补上文档之后它自然排到第一。
第五行我决定保留不修。短查询被泛词稀释是 BM25 的天然边界,用向量检索能盖住,但盖住之后你就不知道边界在哪了。
这几条边界在工程里如实标了出来,用户问到的时候会退回按结构化条件列商品,结果不那么精准,但至少不是编的。
5.3 记忆召回的手该伸多长
导购线有个工具叫 recall_preferences,让模型自己决定要不要查这个人的偏好。
但更重要的召回不在工具里,在主图的装载环节。每一轮进门前,系统会按话题召回长期记忆,塞进系统提示词:
关于这位用户,之前记下的(若与当前说法冲突,以当前为准):
- 身体条件:对夹头敏感,戴眼镜
- 使用场景:通勤坐地铁
- 品牌:云雀(回避)
召回排序是三件事相乘:
score = 置信度 × 时间衰减 × 与当前话题的相关度
时间衰减的半衰期是 30 天。用户上个月的口味不该和上周的一样重。
为什么是相乘而不是加权求和?因为这三件事里任何一项归零,这条记忆就不该被带出来。加权求和会让「置信度极高但完全不相关」的记忆挤进前几名,白占 token。
界面上有个「记忆」标签页,能实时看到三层记忆的内容、置信度、命中次数,也能手动删。记忆系统最需要的是可见性。 一个看不见的记忆库,你没法判断它是在帮忙还是在添乱。
六、订单线:钱的事必须停下来问一句
6.1 算价归代码,模型只管说话
价格是这门生意里最不能出错的一处。让模型自己算,它会给你一个看着合理、但对不上规则的数字,而且每次算得还不一样。
所以这条线的分工是:规则归代码,模型只决定「要不要算」和「跟用户怎么说」。 金额由代码算出来,模型的职责是把数字讲清楚。
算价规则本身有三处容易踩:
| 坑 | 正确做法 | 踩了的后果 |
|---|---|---|
| 门槛按什么价判定 | 满 800 减 100 里的 800,看原价小计 | 混用口径,金额差出几十块 |
| 可叠加与不可叠加 | 可叠加的全上,不可叠加的只取减得最多的那个 | 把规则表从头扫一遍全减上,算出负价 |
| 券码要不要 | 需要券码的,用户没给码就不算进最终金额,但要告诉他「你还有一张能用的」 | 要么少算,要么给了一个用户拿不到的价格 |
加价门槛这条我举个具体数字。工程里有一款明砚 34 英寸带鱼屏,原价 3299 元。
用上全场 95 折和新客立减 30 之后,应付 2838.07 元。门槛判定看的是 3299 这个原价,不是折后的数字。
这里错了,用户看到的价格就差出一档优惠。
6.2 金额超过阈值,流程停下来
这是我在这条线上最想让读者带走的设计。
answer = interrupt({
    "type": "confirm_order",
    "payable": q.payable,
    "threshold": sess.guard.max_amount,
    "reason": f"金额 {q.payable:.2f} 元超过设定的确认阈值 {sess.guard.max_amount:.0f} 元",
})
注意这里做了一件很容易漏的事:确认卡上的金额是代码重新算的,不是模型报上来的。 模型说的应付金额可能是它算错的,让人确认的数字必须是自己算的。
阈值默认 2000 元。工程里 40 款商品只有两款越线,一款 2838.07 元,一款 2280.07 元。用户点「同意」,落单 2838.07 元,与确认卡上的数字一致;点「拒绝」,订单不产生。
这里最重要的一句是:这不是「问一句」的礼貌,是流程上的强制点。 模型没有绕过它的路径,因为它不在模型手里。
6.3 幂等键必须落盘
重复下单这件事,最危险的地方在于它不报错。
第一次请求正常返回,第二次重放也返回一个 200,日志干干净净,账上多了第二笔订单。这类问题在真实系统里的最常见来源是重试和用户手抖。
def make_key(session_id: str, action: str, *parts) -> str:
    raw = "|".join([session_id, action] + [str(p) for p in parts])
    return hashlib.sha256(raw.encode("utf-8")).hexdigest()[:24]
键落在 SQLite,不放在内存里。原因是「重启之后依然要拦住」:进程挂了、服务重启了,用户重放同一个请求,第二笔订单照样不能产生。
验证的方式很直接:把同一笔下单跑两遍,第二次工具返回的是原结果,附带一句「这笔请求之前已经处理过了,没有重复下单」,订单文件里只多一行。
| 护栏 | 落点 | 拦不住会怎样 |
|---|---|---|
| 幂等 | 工具层 + SQLite | 同一笔订单下两次,且不报错 |
| 金额确认 | 支线循环内的中断 | 用户没看过金额就被扣钱 |
| 轮数上限 | 循环计数(不在提示词里) | 模型在两个工具之间反复横跳,一直烧 token |
第三道我想多说一句。提示词里写「不要反复调用工具」是建议,代码里的计数才是约束。 到顶之后循环不抛异常,而是把已经查到的信息交给用户,说明为什么停下来。
七、客服线:把流程写成一个 Skill
7.1 工具查事实,Skill 管判定
客服这条线要处理的是「能不能退」「运费谁出」「超过七天怎么办」。这类问题有个特点:判定逻辑会改,而且改得很频繁。
把判定写进代码,运营改一次口径就要发一次版。把判定写进提示词,它会散落在几十行描述里,越来越难维护。
所以这里用了第三种:写成一个 markdown 文件,src/skills/after-sales/SKILL.md。
## 三、时效判定

1. **七天无理由**:签收次日起七日内。超一天就是超一天,不要含糊说「差不多可以」。
   数码类(耳机、键盘、显示器)要求包装完整、配件齐全。
2. **质量问题**:不受七天限制,按保修期走。
3. **超过七天的无理由**:明确告诉用户不符合,同时给出还能走的路径。
改一行就生效,不用改代码,不用重新部署。
| 谁来做 | 装什么 | 适合什么 |
|---|---|---|
| 工具 | 事实:签收时间、订单状态、类目、引用的条款原文 | 会变但改不动的数据查询 |
| Skill | 流程与口径:按状态分流、时效怎么算、运费谁承担 | 判定规则、话术约束 |
| 代码 | 确定性的计算与拦截:金额、幂等、轮数 | 不能出错的边界 |
这三者的分界线只有一句:工具负责把事实查准,Skill 负责怎么判,代码负责不许越线。
7.2 Skill 里最有用的部分是「不要做什么」
写这个文件时,我把一半篇幅花在了禁令上:
| 禁令 | 原因 |
|---|---|
| 不要承诺具体退款到账时间 | 规则写的是「按原支付渠道退回」,到账由支付渠道决定,说「3 到 5 个工作日」是在编 |
| 不要承诺拦截一定成功 | 物流拦截有成功率,取决于包裹到了哪一环 |
| 不要把邻近的规则当答案 | 用户问促销叠加,检索可能返回发票的文档。答不上就说没查到 |
| 不要在超期时给用户留希望 | 明确说不行,再说还有什么路可走 |
这四条都是我在真实客服场景里见过的话术失控。流程文档的价值,很多时候不在于告诉模型怎么做,而在于告诉它哪些话不能说。
后面那节的护栏会讲,有些话光靠文档是拦不住的,得靠代码。
八、长会话不爆窗口
8.1 治理手段按代价排序
一个会话聊到二十轮之后,如果每轮都把全部历史塞回去,会发生三件事:token 成本线性上涨、模型开始忽略中间的内容、首字延迟越来越长。
治理手段按代价从低到高有三档:
| 手段 | 代价 | 换回什么 |
|---|---|---|
| 裁剪:只留最近 N 条 | 0,纯计算 | 成本有上限。丢信息 |
| 摘要:被裁掉的压成一段话 | 一次模型调用 | 保住结论,代价是被裁掉的内容够多才值得做 |
| 按需注入:记忆只在相关时才带 | 0 | 不无条件全带上,省下的是每轮的固定开销 |
工程里用的是 1 + 2 组合,裁剪是常规动作,摘要有门槛。
8.2 门槛为什么要设
这里有个取舍:被裁掉 3 条消息就去做一次摘要,为省几十个 token 花一次调用,明显不划算。
所以设了两道门槛。第一道是消息条数,历史超过 12 条才开始裁;第二道是被裁掉的内容要有 400 token 以上,才触发摘要。
具体数字,一段 20 轮的对话(40 条消息)经过治理:
| 指标 | 数值 |
|---|---|
| 历史总条数 | 40 |
| 保留 | 12 |
| 裁掉 | 28 |
| 被裁掉的内容 | 1344 token(超过 400 的门槛,触发摘要) |
| 治理后这次请求 | 584 token |
| 不治理全带上 | 1928 token |
| 省下 | 约 70% |
顺带说一个数字:这个工程里的消息平均一条约 48 token。你可以拿它估自己的场景。
8.3 裁剪要按轮次边界切
有个细节值得写下来:裁剪不能直接从中间切。
如果切点落在一问一答中间,留下的历史会以助手的话开头,模型看到的是一段没有提问的答复。所以代码里从后往前找,找到第一个用户消息才切。
cut = len(messages) - keep
while cut < len(messages) and messages[cut].get("role") != "user":
    cut += 1
这个 20 行的函数调了我两个晚上。 症状很隐蔽:不是报错,是模型偶尔答非所问,而且只在大约十几轮之后才出现。
九、循环里那件最容易塌的事
9.1 三处塌陷
这一章是我最想让你看的部分。前面那些设计是「想清楚了再写」的结果,这一章的三件事是「写完跑起来才发现」的结果。
| 塌陷点 | 现场表现 | 处置 |
|---|---|---|
| 工具结果伪装成用户消息 | 模型把工具返回当成「用户又说了句话」,判断对话该收尾,于是编一个订单号宣布成功 | 按协议回灌,用 assistant.tool_calls + role=tool 的消息对 |
| 写操作压在模型记性上 | 手上有报价、用户说了要买,模型就是不调第二个工具 | 写操作由流程接管,触发条件卡死 |
| 流式与护栏的时序 | 谎话已经逐字吐到屏幕上,护栏改的是最终答复 | 前端以最终答复为准覆盖已显示内容,并标注「答复已更正」 |
9.2 第一处:工具结果要按协议交回去
这是我在这整个工程里踩得最深的一个坑。
原来的写法很自然:把工具结果拼成一句话,当成一条用户消息发回去。
# 错的写法
msgs.append(("user", f"以下是工具返回的数据:{result}"))
跑起来之后,模型给出的答复是:
订单号 ORD-20260917001,已下单成功。
它一次都没调过 place_order。
原因在消息的角色上。在模型看来,role=user 意味着又有人说了一句话。
它读到工具结果,接着读到「以下是工具返回的数据」,于是判断这是一轮完整的问答,对话该收尾了。后面那一步它没工具可用,就编了一个结果继续往下说。
正确的做法是按协议回灌,把工具结果放成消息对:
msgs.append(AIMessage(
    content="",
    tool_calls=[{"name": o["tool"], "args": o["args"],
                 "id": cid, "type": "tool_call"}]))
msgs.append(ToolMessage(content=result, tool_call_id=cid))
少了 tool_call_id 的配对,模型收到的是「一次来历不明的工具返回」,行为不稳定。
改完之后模型才开始真的连调工具。这件事跟模型大小无关,9B 和 70B 都会这么干。 它是协议层的错,不是能力问题。
9.3 第二处:不能因为拿到结果就把工具收走
上面那个坑还有第二个成因,而且它更隐蔽。
原来我的循环里有这么一条判断:一旦这一轮已经拿到过工具结果,下一轮就不再给它绑工具,让它专心组织答复。
听起来很合理,实际上是错的。真实任务常常是三步:先认货、再算价、最后下单。
如果第一轮之后就不给工具,链路只能走一步。模型没有工具可用,它就编。
所以现在工具全程绑着,用 bind_tools 一直挂着。它可能还要再调一次,也可能直接收尾,两种结果循环都要接得住。
9.4 第三处:写操作不交给模型的自律
工具交回去之后,我以为事情就好了。结果是另一个样子。
用户说「帮我下单明砚 34 英寸带鱼屏 一台」。模型先检索、再算价,拿到了完整的报价:单价 3299 元,已生效优惠 460.93 元,应付 2838.07 元。然后它停下来了,开始写答复:
已为您下单,实付 2838.07 元。
place_order 依然没被调用。
我试着掰了三种写法:明令它必须调用、给它一个典型反例、把步骤拆成逐条引导。三种都没用。
它手上有完整报价,用户也明说了要买,它就是不肯调第二个工具。
我后来想明白了这件事的性质:这不是幻觉,是一种「任务完成的错觉」。在它的理解里,用户想要的东西已经算清楚了,剩下的动作像是系统会自己完成的,不需要它再做什么。
最后的处置是把写操作从模型手里接过来:
def _force_write(sess, role, state):
    if role != "order":                       # 只有订单线有写操作
        return None
    obs = state.get("observations") or []
    if not obs:                               # 模型这一轮动过手
        return None
    if "place_order" in {o["tool"] for o in obs}:
        return None                           # 没下过单
    if not looks_like_purchase(sess.facts["last_user_text"]):
        return None                           # 用户明确说了要买
    ...
    return {"tool": "place_order", "args": {...}, "call_id": "harness_place_order"}
触发条件卡得很死,四条同时满足才接管。而且接管不绕过任何一道确认:
| 接管之后仍然要走的 | 说明 |
|---|---|
| 金额确认 | 超过 2000 元照样中断,照样弹确认卡 |
| 幂等 | 落单照样过幂等键 |
| 工具返回 | 落单成功与否,以工具返回为准 |
这是一个我认为值得记住的判断:当一件事的正确性不能依赖模型时,把它从模型手里拿走,而不是把提示词写得更长。 提示词是建议,代码才是约束。
9.5 两条额外的护栏
第四章埋的那个伏笔在这里收一下:路由把「要办掉」的话判成导购线时,模型会走错线。
同时还有另一种更隐蔽的编造:模型不去检索,直接给出一个商品编码和价格,说得有零有整。
这款 SKU-D3015 现在 459 元。
而库里根本没有 D3015 这个编码。
两条护栏都是确定性的字符串检查,很便宜:
| 拦什么 | 怎么判断 | 拦下之后 |
|---|---|---|
| 编造的商品编码 | 用正则把答复里的编码抠出来,逐个去库里认,认不出的就是编的 | 换成如实答复,让用户重说一次需求 |
| 没有凭据的成功话 | 答复里出现「下单成功」「订单号是」这类词,但这一轮没有任何写工具成功返回过 | 换成「这笔订单还没有真正提交」 |
第二道护栏里有个细节差点酿成事故。用户拒绝金额确认之后,系统会在观察里记一条 place_order 的结果,内容是「用户没有确认,系统未下单」。这条记录顶着 place_order 的名字,于是「有没有成功执行过写操作」的检查把它当成了一次成功下单,放行了模型编出来的「已为您下单 2280.07 元」。
修法是给它加一个明确的标记:
{"tool": "place_order", "args": args, "executed": False, ...}
检查的时候尊重这个标记:executed=False 的那些不算写操作。
护栏自己也要经得起检查。 一道护栏误判成「操作已发生」,比没有护栏更危险,因为它会让谎话顺利通过。
9.6 流式与护栏有天然时序差
最后一处,也是最隐蔽的一处。
为了让用户不用干等,答复是逐字流式吐出来的。护栏在答复形成之后才生效,改的是最终答复。
于是在日志里出现过这样的场景:模型先流式吐出一段「订单已生成!实付 2280.07 元」,护栏把它拦下换成「这笔订单没有提交,也没有产生任何扣款」,但屏幕上前面那段谎话已经一个字一个字显示完了。
处置分两半:
| 半 | 做法 |
|---|---|
| 前端 | 收到最终答复时,替换已经流式显示的内容,而不是追加。并标上「答复已更正」 |
| 后端 | 终帧带上明确的事件类型,让前端能区分「流式片段」和「最终答复」 |
这件事让我对「流式」有了新的认识。流式把护栏的生效点后移了。
所有在答复之后才做的检查,都会有一个「谎话已经上屏」的窗口期。你只能事后覆盖,覆盖不了就标注。
十、算账
10.1 一轮对话花多少钱
前面有篇讲上线的文章算过容量和成本。这里把口径缩到单次对话。
一次完整问答的 token 消耗,主要来自四类调用:
| 调用 | 什么时候发生 | 量级 |
|---|---|---|
| 路由 | 每轮一次 | 小。输入是历史尾部 + 本轮输入 |
| 支线思考 | 每轮 1 到 N 次(N 是工具调用轮数) | 大。输入是完整系统提示词 + 历史 + 工具定义 + 观察结果 |
| 记忆召回 | 每轮一次 | 零模型调用。纯本地打分排序 |
| 记忆抽取 | 有信号时才发生 | 中等。输入是最近 6 条消息 |
我注意到一个规律:一次多步任务的费用,主要花在支线思考的第二次和第三次调用上。 第一次调用输入还小,第二次开始带上工具定义和观察结果,输入长度跳一档。
所以省钱的位置不在路由,也不在记忆,在工具返回的内容有多长。工具返回一句 300 字的商品列表,接下来每一轮思考都要重新看一遍这 300 字。
这个工程里所有工具都有意识地压结果长度,只给模型用得上的字段。工具的输出格式,是一种成本控制手段。
10.2 多 Agent 的成本放大在哪
第四章讲了为什么切三条支线。这里说代价。
| 方案 | 相对成本 | 放大在哪 |
|---|---|---|
| 单 Agent 一个循环 | 1.0 | 提示词最长,工具定义最多 |
| 三条支线共用循环 | 约 1.05 | 只在路由多一次调用。工具清单变短了一部分抵消 |
| 三个独立 Agent 互相转交 | 1.5 起 | 转交本身要一轮调用,而且可能来回转 |
三条支线的成本接近单 Agent,原因是它们共用同一个循环,且每次只带自己那几个工具的定义。切分的成本主要不在「切」,在「转」。 只要没有转交,切分几乎是免费的。
这条结论跟前面那篇多 Agent 的文章是一致的:贵的是专家之间的交接,不是专家本身。
十一、换成你自己的,改这几处
到这里,这个工程已经能跑、能验、也能改。它对你有没有用,还取决于剩下的一件事:它是一副能换零件的骨架,还是一整块只能看的东西。
差别在你要换东西的时候才显出来。演示是一整块,换个数据源要重写一半。骨架是分层的,层与层之间只有一个窄接口,你只动那一处。
这九处外部依赖,我一个个收进了单独的文件或函数里。
11.1 九处接口
| # | 换什么 | 现在的实现 | 上生产换成什么 | 改哪里 |
|---|---|---|---|---|
| 1 | 模型后端 | 一个 OpenAI 兼容客户端,本地端点与云端预设都在 | 你自己的模型服务,云端或自建,只要兼容这个协议 | src/brain.py 的 make_brain() |
| 2 | 数据源 | 7 个 JSONL,40 款商品 | 你的商品库、订单库、政策库 | src/dataset.py 的 get_catalog() |
| 3 | 检索 | 纯 Python BM25,中文按二元切分 | Elasticsearch、Milvus 配 bge-m3,或你现有的搜索接口 | src/retrieval.py 的 search() |
| 4 | 长期记忆 | SQLite 单文件,三张表 | Redis、PostgreSQL,或独立的记忆服务 | src/memory.py,方法签名可以不动 |
| 5 | 会话检查点 | SQLite checkpointer | Postgres checkpointer,多副本之间共享 | src/runtime.py 里取 checkpointer 那一处 |
| 6 | 幂等表 | SQLite,幂等键落盘 | Redis,或在你自己的业务库上加唯一索引 | src/guard.py 的幂等三件套 |
| 7 | 工具 | 8 个函数,按支线分组下发 | 你的接口,包一层就行 | src/tools/ 下加文件,在 TOOL_GROUPS 里登记 |
| 8 | 业务口径 | 一个 markdown 文件 | 你的售后规则与话术禁令 | src/skills/after-sales/SKILL.md |
| 9 | 界面 | 原生 JS 三栏页,SSE 流式 | 你的前端,或只留接口嵌进现有系统 | web/ 与 src/server.py |
最省事的是第 7 项。工具只要满足两条:接收一个参数对象,返回一段字符串。你手上的接口包一层就能挂上去。
第 3 项和第 4 项要多花点心思,因为这两处的排序逻辑跟业务绑得最紧。检索里的 where 过滤、记忆里的置信度与时间衰减,换成你的数据之后权重要重新调一遍。这两处调不好,Agent 不会报错,只会答得不对。
11.2 换完之后,有五处别动
| 别动 | 为什么 |
|---|---|
| 主图那四个环节 | 「进门治理、出门归档」这个位置是试出来的。挪进支线里,三条线拿到的历史会不一致 |
| 路由的判据 | 「了解还是办掉」这条线划错,后面所有护栏跟着失效 |
| 循环的形状 | think 加 act,一条回边,够用。节点加多了,状态更难追 |
| 三道护栏的位置 | 幂等在工具层、金额在支线循环里、轮数在计数上。挪位置等于放开门 |
| 工具按支线发 | 发全量会让误选概率和 token 一起涨 |
这五处管的都是边界,跟具体业务无关。业务怎么变,它们都不用动。这也正是它们能留在骨架里的原因。
11.3 上线前,我会先确认这五件事
| 要确认的 | 判断标准 | 这个工程里的位置 |
|---|---|---|
| 写操作有没有从模型手里拿走 | 提示词里写「必须调用」不算,代码里得有一个强制点 | 9.4 的 _force_write() |
| 幂等键落没落盘 | 重启服务再重放同一个请求,订单文件不该多出一行 | 6.3 的幂等表 |
| 不能错的数字是不是代码算的 | 钱、时效、库存这类字段,模型只能引用不能生成 | 6.1 的 compute_quote() |
| 每条线的轮数上限设了没有 | 上限写在代码里。写在提示词里的那个是建议 | 6.3 的循环计数 |
| 中间过程看不看得见 | 出问题的时候,你能不能答出「它第几步开始错的」 | 1.2 的过程面板 |
五条都过了,这副骨架就可以接你的业务。有一两条没过,先补上再上。
这五条里没有一条跟模型能力有关。换个更强的模型会让人舒服一些,但它替不了这五件事。
十二、留给你的三个问题
工程到这里就说完了。它能跑、能验、能改、能换,也有明确说出来的边界。
我想留三个问题给你,都是我在装这条线的时候真正停下来想过很久的:
第一,你的 Agent 有没有一个「看得见」的地方?
这个工程里三处最严重的塌陷,全部是靠过程面板发现的。如果只能看到最终回答,你看到的是一个偶尔胡说八道的模型,看不到它在哪一步开始胡说的。
第二,有哪些事你已经写进了提示词,但它其实应该是代码?
我这个工程里至少有三件:轮数上限、金额阈值、写操作的触发。提示词是建议,代码是约束。一件事如果你不能让模型做错,就别放在提示词里。
第三,你有没有让护栏自己也被检查过一遍?
9.5 节里那道差点放行谎话的检查,本身也是一道护栏。护栏误判比没有护栏更危险,因为它会让你以为这件事已经被管住了。
这一路上我们拆过上下文、拆过记忆、拆过工具接入、拆过评测,也拆过上线之后会坏的每一类事。现在这套零件在你手里了,剩下的就看你想为谁做点什么。
工程放在这里,pip install -r requirements.txt,然后 python run.py。不用配任何东西,它会先以规则模式跑起来给你看链路。等你觉得可以了,再把你的模型接上去。
它不完美,检索的边界我在第五章如实列了四条。但它是一副能换零件的骨架,一个能换成你自己的东西,比一个演示得更漂亮的玩具有用得多。
这个工程是完整可跑的
一个带浏览器界面的购物助手 Agent,配好模型地址和密钥就能对话。
在公众号后台回复 shopagent,领取完整工程包。
解压之后两行命令就能起服务,不配模型也能先跑起来看链路。